宇树于9月14日发布G1+,集中升级了机器人的感知与运动能力。
颈部增加2个自由度,视觉系统升级为双目相机、广角单目相机和3D激光雷达;肩部与腰部电机的峰值扭矩提升一倍以上,发热量降低约70%。远场拾音系统升级为前4后2的六麦克风阵列,支持声源定位与降噪。头顶新增5个触摸点,背部增加DC 54.6V/5.7A外部供电接口,可支持持续供电运行。六项升级均集中在硬件,含税售价为9.5万元。
身体越来越像人。装在里面那颗脑子,这次一个字没提。
模型的事,四天前已经公布。9月10日,宇树发布新一代通用人形机器人基础模型UnifoLM-WLA-1.0,其中WLA是World-Language-Action,即世界-语言-动作。模型规模为6B;配套的UnifoLM-ER-1使用超过500万条具身推理样本,WLA模型使用约2500小时真机数据,一个模型覆盖64项任务,包括10项全身操作和54项桌面操作。9月11日,首批权重上线。
一具身体挂价签,一颗脑子挂许可证。
9 月 7 日晚上,一段 38 秒的视频。画面里没有遥控器,没有人举着 VR 头显。一台 G1 站在场地中间,人类拳手出拳,它双拳收到胸前格挡;一记鞭腿扫过来,它退后半步,稳住,回身还了一拳。视频上打了四个字:全程实拍,无加速。
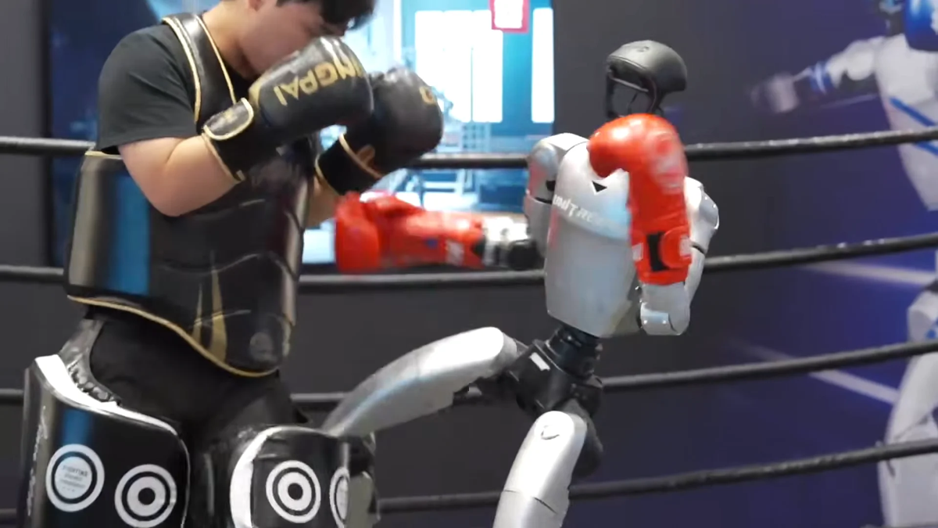
图注:9 月 7 日演示画面,场地里没有遥控器,也没有 VR 头显。图片来源:宇树科技官方演示视频
宇树把这场演示称作全球首次由世界模型实时驱动的全自主人形机器人格斗,背后是另一套模型 UnifoLM-X2-1.0。
这三次发布集中在一周内:先用格斗演示实时决策能力,再开放新一代模型,随后发布升级后的机器人本体。
01.先打一场,三天后再开源
先把时间线摆出来。
2025 年 9 月,UnifoLM-WMA-0 开源,WMA 是 World-Model-Action,核心词是世界。它的任务是把机器人动完之后世界会怎么变预测出来,可以当仿真引擎造训练数据,也可以接上动作头增强决策。
2026 年 1 月,UnifoLM-VLA-0 开源,VLA 是 Vision-Language-Action,核心词换成动作。底座换到 Qwen2.5-VL,在 G1 上用一套策略跑通 12 类复杂操作任务。
2026 年 9 月,宇树发布UnifoLM-WLA-1.0。WLA是World-Language-Action,即世界-语言-动作,指向世界建模、语言理解与动作生成的统一。
把三个名称放在一起,可以看出宇树这一年的技术路线:先建模世界变化,再生成机器人动作,最后把世界变化预测、语言理解和动作生成纳入统一模型。
图注:9 月 10 日宇树发布的开源主视觉,背景是官方演示里的任务画面。图片来源:宇树科技官方项目页
宇树将9月发布的新模型命名为WLA-1.0。WLA是World-Language-Action,即世界-语言-动作,与前文所述统一世界建模、语言推理和动作生成的技术方向一致。
9 月 7 日那场格斗用的 X2-1.0,没有出现在这批开源清单里。
02.会认出杯子,不等于会伸手
要理解 WLA 想解决什么,得先知道 VLA 卡在哪。
过去两年机器人的视觉能力进展很快,能认出桌上是个杯子,能认出椅子和门。可认出和动手之间隔着一道沟。
识别杯子,与判断杯子距桌沿多远、机械臂应从哪个角度接近、动作是否会碰倒旁边的水瓶,是两种不同层次的能力。这种感知与动作之间的落地差距可称为grounding gap。视觉语言模型从互联网图文中学到的知识,仍需经过具身数据训练才能转化为可靠的物理动作。
宇树这次的答卷分两层。第一层是同步亮相的具身推理模型 UnifoLM-ER-1,4B 参数,底座是开源的 Qwen3-VL-4B,用了超过 500 万条具身推理样本,覆盖图像点预测、物体检测、多图推理、2D 轨迹预测、3D 物体检测、多图空间问答六类任务。
在16项多模态感知与理解基准中,UnifoLM-ER-1有7项领先表中参评的开源模型:RefSpatial-Bench、Where2Place、PixMo-Point、BLINK、EmbSpatial、RoboSpatial和VSR。
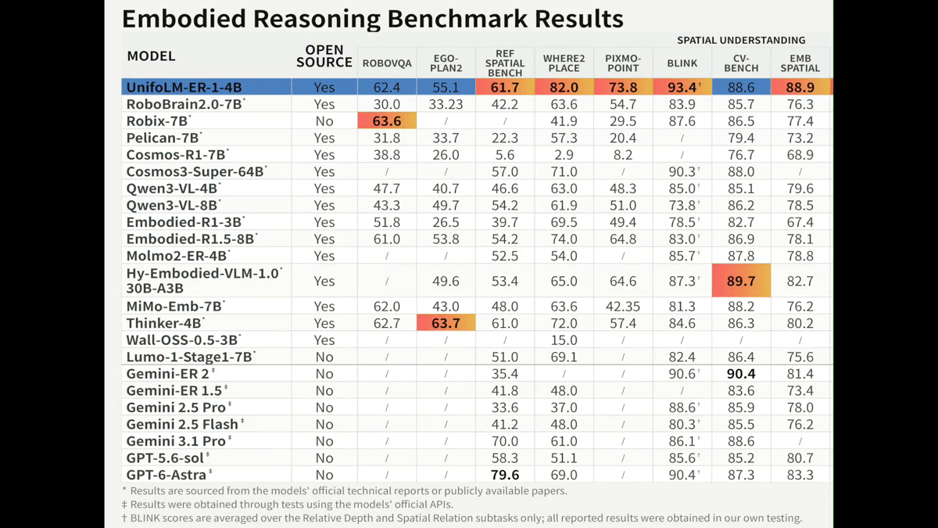
图注:官方演示视频里的成绩表,UnifoLM-ER-1-4B 排在第一行。按表格脚注,各家数据来自模型官方技术报告、公开论文,或者用模型官方 API 自测;BLINK 只取其中两个子任务的平均。图片来源:宇树科技 UnifoLM-WLA-1.0 官方演示视频
以其中两项为例:物体摆放预测Where2Place得分82.0,空间关系理解VSR得分88.1。两项基准都涉及机器人执行动作前的空间判断,例如目标位置能否放置物体、机械臂的运动是否会与周围物体发生干涉。
这些分数需要结合评测方式理解。表中数据来自各模型的技术报告、公开论文和API测试,BLINK也只统计两个子任务,因此并非在统一模型版本、推理设置和评测流程下完成的横向比较。
03.世界模型走了条省钱的路
第二层是这套模型里最有意思的地方。
VLA 之后,行业里冒出一条新路线,叫 WAM,World-Action Model,世界-动作模型。思路是让机器人先学会预测世界怎么变,再从变化里推出动作。这个方向更接近人的直觉:人要挪走一个杯子,脑子里会先过一遍杯子挪开后桌面变成什么样。
WAM通常需要生成完整的未来画面,逐帧预测后续变化。在一张512×512像素的图像中,大量背景区域与当前任务无关,完整视频生成仍会为这些区域分配计算量。
UnifoLM-WLA-1.0不生成完整的未来画面,而是只预测未来会发生变化的区域。
做法是,用光流从前后两帧里提取出真正发生变化的区域,再用 VQ-VAE 把这片连续变化压成固定长度的离散 token,然后训练模型:给它当前画面加任务描述,直接输出未来会变的区域。宇树管这个叫 Dynamic Region,动态区域。
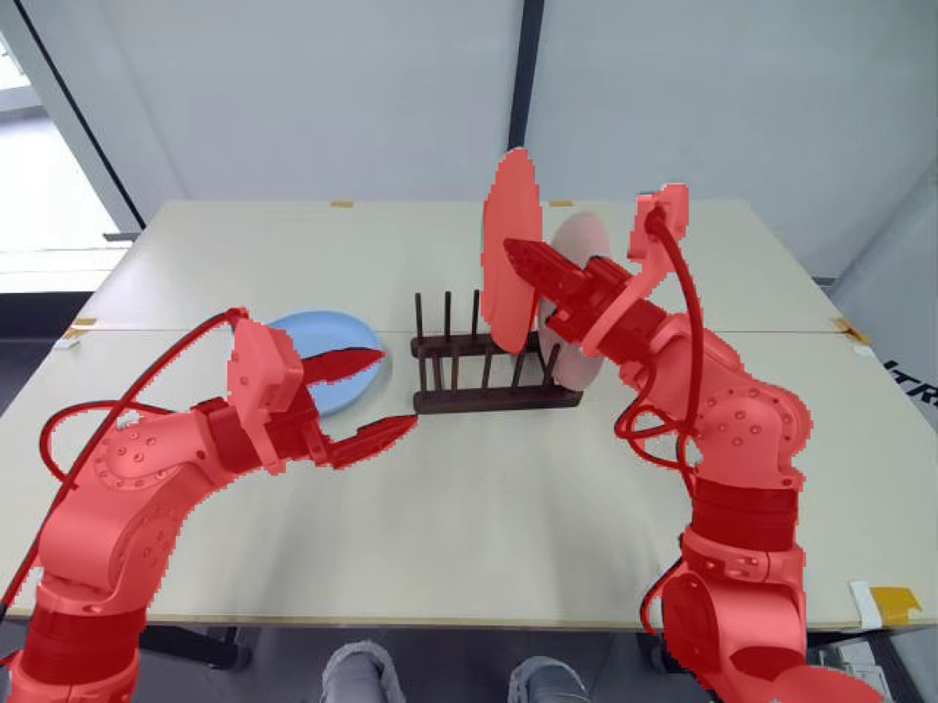
图注:红色区块表示模型预测的未来动态区域,图中其余部分未被标记为动态区域。图片来源:宇树科技官方项目页
叠毛巾,真正会变的只有毛巾本身,加上它被挪走后露出来的那块桌面。房间里其他像素纹丝不动。
官方把这条路总结成 interaction-centric world modeling,以交互为中心的世界建模。说人话就是,与其画一张模糊的全景未来,不如把哪儿会变算准。前者好看,后者有用。
这种设计不追求还原完整未来画面,而是把预测目标集中到与交互相关的区域,从而减少对无关背景的建模。
04.把动作切成词,让全身说同一种语言
光会看不够,动作还得能被模型统一表达。
不同身体部位和末端执行器常采用不同的动作表示与控制模块。腿部行走、机械臂运动和手部抓取的控制目标并不相同,更换末端执行器还会改变动作空间的维度和语义,因此统一建模并不容易。
宇树的做法是把动作也切碎。
它把机器人的动作拆成三段:末端执行器的位姿、手部关节、下半身关节。三段各训一个残差向量量化模型,把连续轨迹编码成离散的动作 token。三组 token 按共享时间步对齐,一起送进视觉语言模型。
手部精细动作、末端轨迹和下肢运动分别被编码为离散token,并按共享时间步对齐后输入视觉语言模型。模型由此可以像预测语言token一样预测动作token。
同一模型联合生成末端位姿、手部关节和下肢关节的动作,实现全身协同控制。
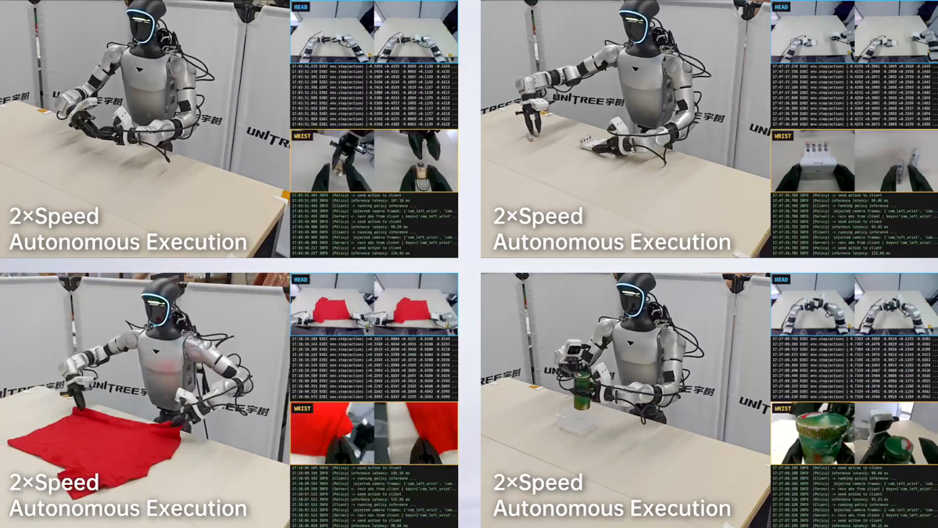
图注:官方演示里的桌面任务,画面标注 2 倍速自主执行,右上和右下分别是头部与腕部相机的实时画面。图片来源:宇树科技 UnifoLM-WLA-1.0 官方演示视频
这些模块共同构成主干网络UnifoLM-ER-Flow。主干网络之上连接MMDiT动作专家,用于把多模态表征解码为连续动作指令。
主干网络负责多模态感知与理解,动作专家负责生成连续动作。这样的模块分工让语义建模与动作生成分别由更合适的网络结构承担,也为端侧部署留下了优化空间。
05.2500 小时真机数据,才是最贵的部分
公开的模型结构可以被研究者借鉴,但高质量真机数据的采集、清洗和标注更难复制。
UnifoLM-WLA-1.0 的训练数据约 2500 小时,官方点名了两类来源,宇树自有开源数据集,以及 BitRobot-HIW-500 这类公开资源。
HIW-500由BitRobot、Hugging Face与宇树联合发布,包含500多小时真实家庭场景中的全身遥操作数据。数据使用Unitree G1采集,覆盖29个机器人自由度;头部配备立体相机,腕部配备红外立体相机,并采用CC BY 4.0协议开放。

图注:G1 在真实家庭客厅里执行清洁任务,这类带家具、杂物和动线的场景正是全身遥操作数据要覆盖的对象。
真机数据为什么贵。仿真里跑得完美的策略,搬到真机上可能连东西都抓不住,材质、摩擦、光照的每一点差别都会让动作变形。采真机数据要有人遥操作一台机器人,一小时下来收不回一小时能用的高质量数据,中间还有设备损耗、失败样本、清洗标注。
真实物理交互数据仍然稀缺。可用于训练的合规真实交互数据与通用具身模型所需的数据规模之间仍存在数量级差距。
填这个缺口有两条路。
一条是宇树走的这条,用真机遥操作采集,数据准,和本体严格对齐,代价是慢,产能取决于手里有多少台机器人。
另一条是拿人类第一视角视频来学。9 月 9 日发布 PhysBrain 1.5 的深度机智走的是这条,用全景设备采集人的日常操作视频,再把人的动作转换到机器人上。数据便宜、量大,代价是要跨过人和机器人的形态差异。
真机遥操作数据与人类第一视角视频各有优势:前者与机器人本体严格对齐,但采集成本高;后者规模更大、成本更低,但需要解决人类动作向机器人动作迁移的问题。实际训练可以根据任务需要组合两类数据。
06.感知跑分之外,还要看真机任务成功率
最后说这套模型还没有证明的部分。
同一个UnifoLM-WLA-1.0模型覆盖64项任务,包括10项全身操作和54项桌面操作。
这件事的价值不在数量,难点在一个。同一套参数,上要管手指的精细动作,下要管全身的移动和平衡,任务之间还不能打架。过去每个任务训一套模型,边际成本压不下来。
边界也得看清。
64 项任务全在宇树自己的 G1 上测,换成别的品牌机器人行不行,还没有数据。前面那 7 项第一,测的也偏向空间理解,属于眼睛的考试,跟真机操作成功率是两回事。
感知与空间推理基准衡量的是模型理解环境的能力,不能替代真机任务成功率。分布外任务和新本体上的性能通常会下降,跨任务、跨场景和跨本体泛化仍是具身模型需要解决的问题。
截至9月14日,可下载内容包括具身推理模型、主干网络权重和挑战赛数据集、全身遥操作数据集;后训练代码、UnifoLM-WLA-Base权重仍列在后续开放计划中。
回到那场擂台
格斗是最难的场景,也是最取巧的场景。
格斗场景对实时反应、物理判断和动态交互提出了很高要求,系统需要在数百毫秒内完成感知、预测、决策和控制,并在受到冲击后迅速恢复平衡。但该演示的边界也很明确:对手动作和场地条件相对受控,不能单独证明机器人在开放环境中的泛化能力。
这段演示说明系统能够在特定场地和对抗条件下完成实时闭环动作,但还不足以说明其长期稳定性和开放环境泛化能力。
从可行走向可用,还需要回答几个具体问题:轻量世界模型能否处理长尾情况,动作token化能否跨越本体差异,约2500小时真机数据能否支撑更广泛的任务泛化。研究者可以在许可证允许的范围内下载已开放的权重和数据进行验证。
宇树创始人王兴兴在世界机器人大会上给过一把尺子:机器人在 80% 的陌生场景里,仅凭一句语音或文字指令完成 80% 的任务,具身智能才算迎来自己的ChatGPT 时刻。他给的时间是快则两三年,慢则五到十年。
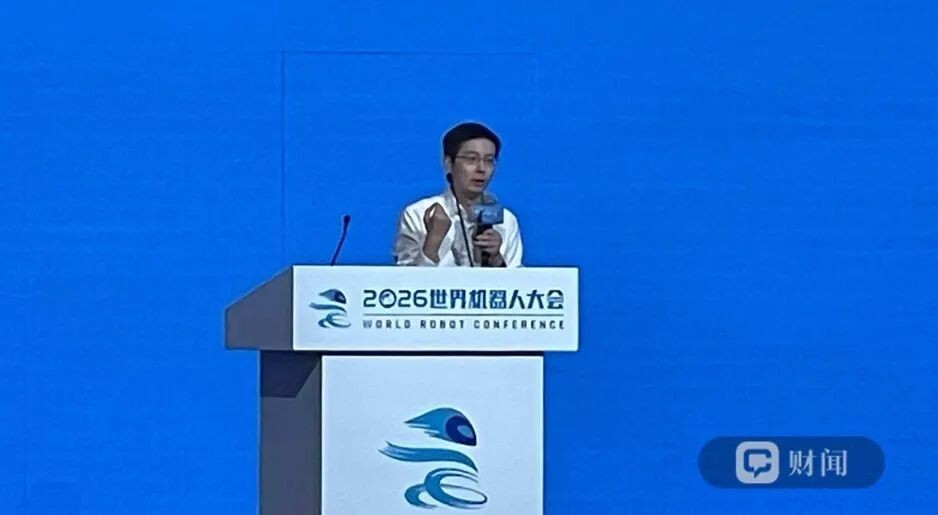
图注:王兴兴在 2026 世界机器人大会主论坛发表演讲《从展品到产品:人形机器人产业的下一个十年》。
接下来更值得关注的是开放环境中的任务成功率、跨本体泛化能力,以及长时间运行的稳定性。